Appearance
统计分析
统计分析用于查看一段时间内的整体运行情况,包括执行规模、错误数量、平均耗时和模型 Token 用量。
它适合回答以下问题:
- 最近执行量是否发生明显变化;
- 错误是否突然增加;
- 整体响应是否变慢;
- Token 增长来自使用量增加,还是单次执行变得更复杂;
- 新版本发布后,整体表现是否发生变化。
统计分析用于发现趋势和判断影响范围。需要继续定位某一次具体执行时,应进入链路追踪。
一、功能边界
应用日志、链路追踪和统计分析关注的范围不同:
| 需要解决的问题 | 建议入口 |
|---|---|
| 某位用户反馈某次回答有问题 | 应用日志 |
| 想知道具体哪一步出错或耗时 | 链路追踪 |
| 想查看一次执行的输入、输出和错误 | 链路追踪 |
| 想判断问题是单次异常还是普遍现象 | 统计分析 |
| 想观察一段时间内的执行规模、错误和 Token | 统计分析 |
通常先通过统计分析发现整体异常,再进入链路追踪定位具体执行;如果问题来自某位具体用户,则先从应用日志定位目标消息。
二、进入统计分析
在左侧菜单中进入 应用观测 → 统计分析。
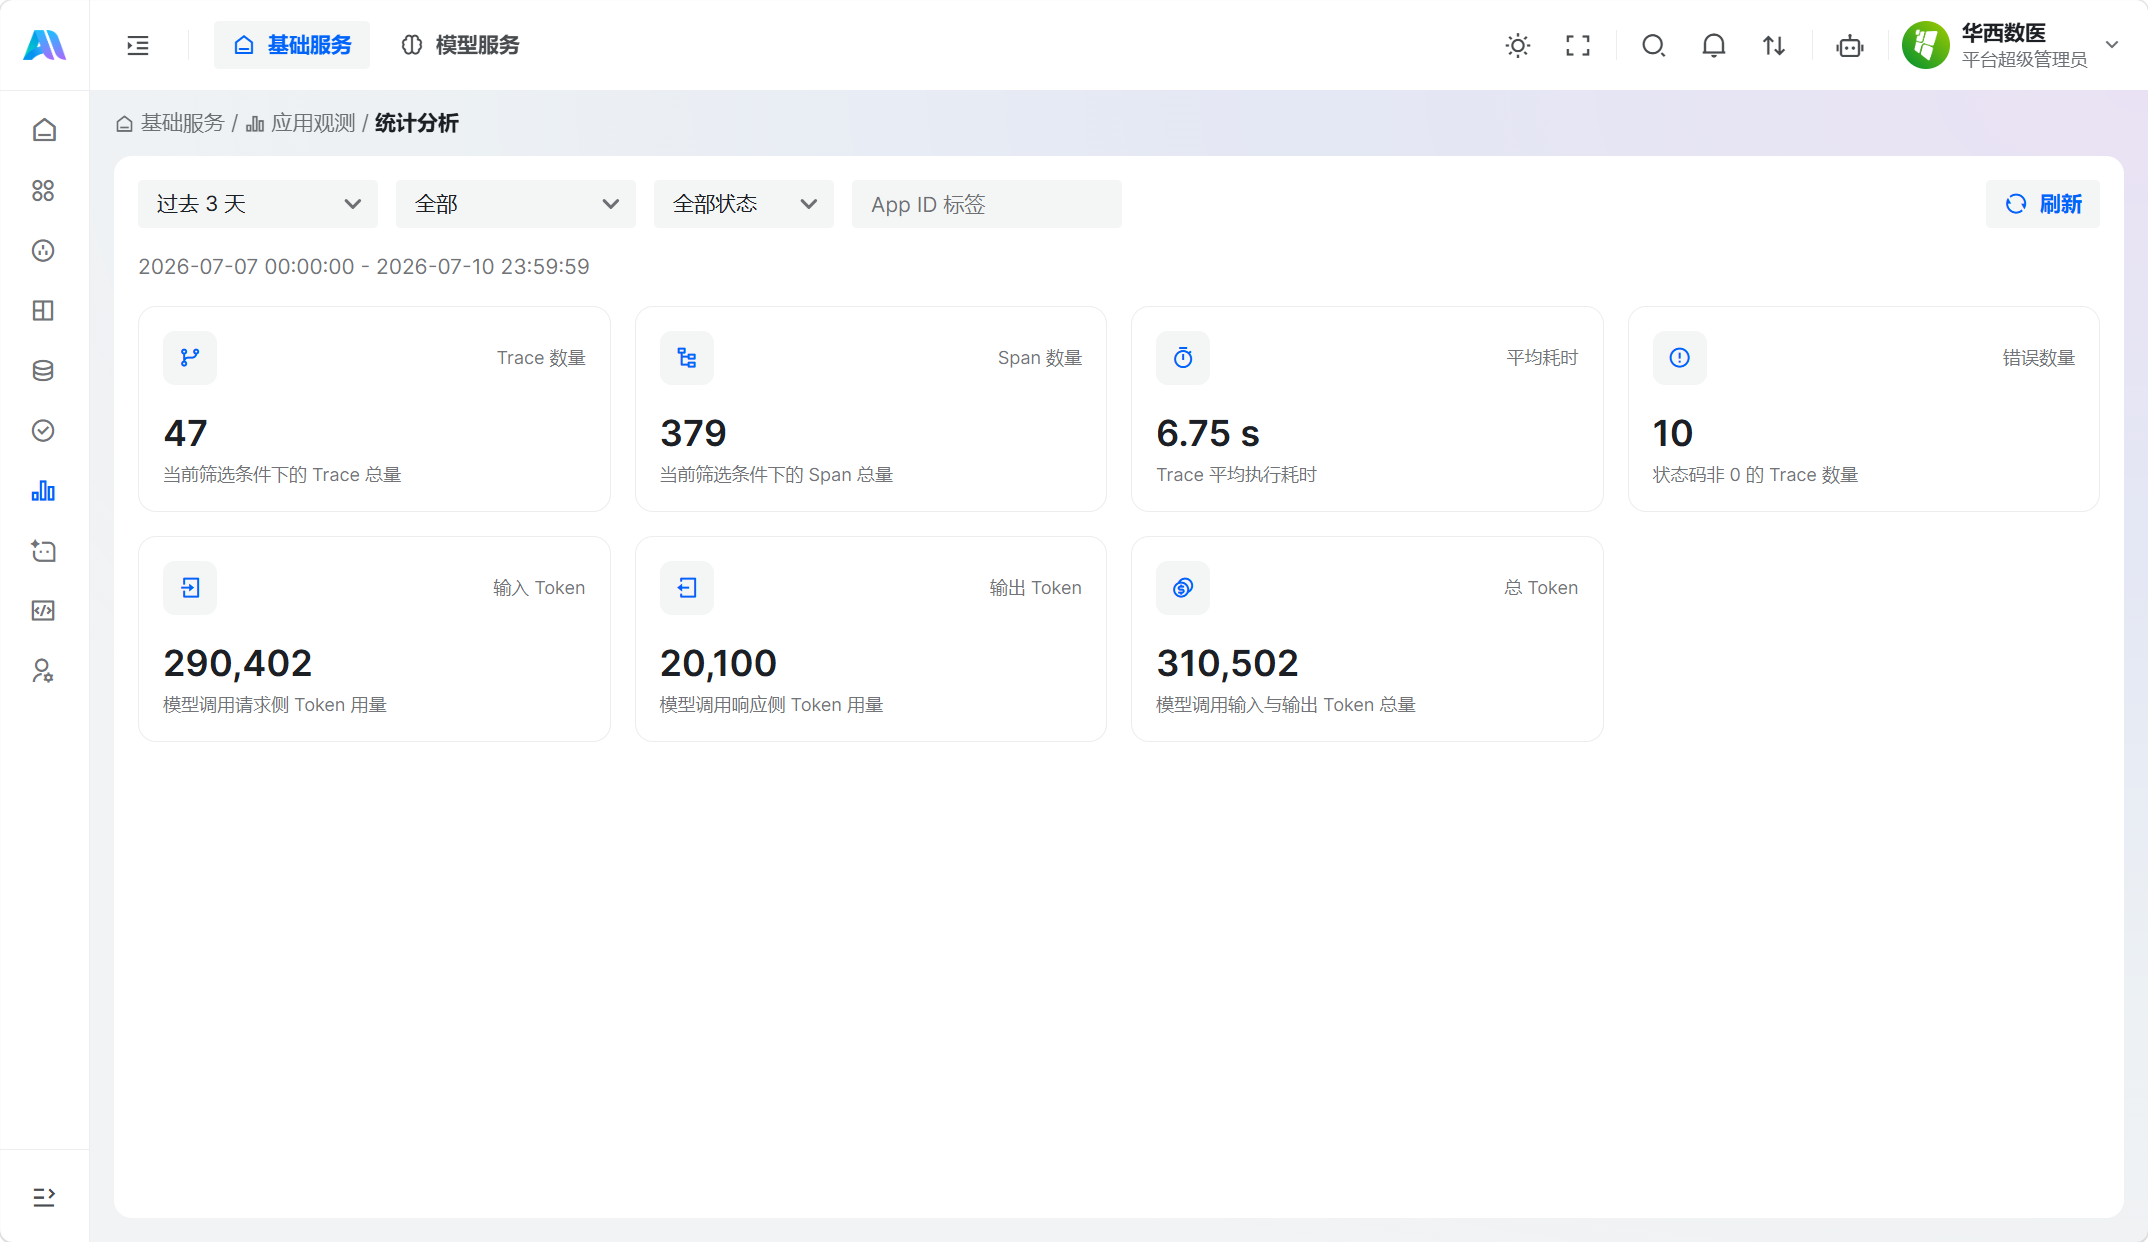
页面由筛选区和指标卡片组成:
- 筛选区决定本次统计的数据范围;
- 指标卡片展示当前范围内的汇总结果;
- 修改筛选条件后,点击右上角 刷新,页面会重新统计。
读取指标前,先确认筛选条件和页面显示的具体起止时间。不同统计范围下的数字不能直接比较。
三、选择统计范围
页面提供时间范围、Span 类型、状态和 App ID 标签四项筛选。
3.1 时间范围
选择“过去 3 天”等快捷范围后,页面下方会显示实际的开始时间和结束时间。所有指标均以这个具体区间为准。
进行前后对比时,应选择长度一致、业务情况相近的时间范围。例如比较新版本发布前后的表现,可以分别统计发布前 3 天和发布后 3 天。工作日、节假日或业务高峰期的使用规模可能差异较大,不宜直接比较总量。
3.2 Span 类型
Span 类型用于缩小统计对象的类型范围,例如工作流、Agent、模型调用或检索。
不同类型的执行结构和耗时差异较大。分析某类问题时,应选择对应类型,避免把完整工作流、模型调用和知识检索混在一起比较。
| 分析目标 | 建议选择 |
|---|---|
| 查看完整工作流的运行情况 | 工作流 |
| 查看 Agent 执行情况 | Agent |
| 分析独立模型调用 | 模型调用 |
| 分析知识检索 | 检索 |
| 查看整体规模 | 全部 |
具体可选类型以当前页面下拉列表为准。
3.3 状态
- 全部状态:统计正常和异常记录;
- 正常:查看正常执行;
- 异常:查看异常执行。
分析整体健康情况时先使用“全部状态”;排查错误增加时再切换为“异常”,缩小统计范围。
3.4 App ID 标签
App ID 标签用于将统计范围缩小到某个应用。App ID 是应用的唯一标识,不是应用名称;填写时应使用目标应用的完整 ID。
不填写 App ID 时,页面统计其他筛选条件下的全部匹配数据。
修改任一筛选条件后,需要点击 刷新。刷新前,指标卡片可能仍是上一次查询的结果。
四、理解核心指标
4.1 Trace 数量
Trace 数量表示当前筛选条件下匹配到的执行记录总量。
它可以反映执行规模,但不一定等于用户消息数。一次业务处理可能涉及应用、工作流、知识检索或模型调用等不同执行入口。因此,查看业务使用规模时,应先限定统计类型或 App ID。
4.2 Span 数量
Span 数量表示当前统计范围内记录的操作步骤总量。
一个 Trace 可以包含多个 Span。例如,一次工作流执行可能包含提示词处理、模型调用、知识检索和工具调用等多个 Span。
Span 数量不能与工作流画布节点数直接等同,也不能与 Trace 数量相加。观察 Span 数量时,应结合 Trace 数量判断:
- Trace 数量和 Span 数量同时增加,通常表示整体执行规模增长;
- Trace 数量基本不变,但 Span 数量明显增加,可能表示单次执行步骤变多;
- Agent 重复调用工具、循环次数增加或流程变复杂,都可能造成 Span 数量增加。
需要比较单次执行复杂度时,可以辅助计算:
text
平均每条 Trace 的 Span 数 = Span 数量 ÷ Trace 数量该结果是人工计算的辅助指标,不是平台直接展示的指标。
4.3 平均耗时
平均耗时表示当前统计范围内 Trace 的平均执行时间。
平均值适合观察整体变化,但少量特别慢的 Trace 可能拉高结果。使用时应注意:
- 对比前后两个周期时保持筛选条件一致;
- 不要把不同类型的执行混在一起判断性能;
- 发现平均耗时明显升高后,进入链路追踪查看具体慢请求;
- 页面没有展示中位数、最大值或 P95 等指标时,不能仅根据平均耗时判断所有请求的实际等待情况。
4.4 错误数量
错误数量表示当前筛选条件下,执行状态码非 0 的 Trace 数量。页面会将这类 Trace 标记为“异常”。
这里的状态码是 Trace 的执行状态,不应直接理解为外部接口的 HTTP 状态码。
错误数量需要结合 Trace 数量判断。页面没有直接展示错误率时,可以辅助计算:
text
错误率 = 错误数量 ÷ Trace 数量 × 100%参与计算的错误数量和 Trace 数量必须来自完全相同的筛选条件。
4.5 输入 Token
输入 Token 表示模型调用请求侧消耗的 Token,可能来自:
- 系统提示词;
- 用户输入;
- 对话历史;
- 工作流变量;
- 知识库召回内容;
- 工具返回后继续交给模型处理的数据。
输入 Token 明显增加时,应优先检查提示词、对话上下文、知识检索结果和传入数据是否变长。
4.6 输出 Token
输出 Token 表示模型生成响应消耗的 Token。
输出 Token 明显增加时,应检查输出长度要求、最大输出配置,以及 Agent、循环或重试是否触发了额外的模型调用。
4.7 总 Token
总 Token 是输入 Token 与输出 Token 的合计:
text
总 Token = 输入 Token + 输出 Token不要把输入 Token、输出 Token 和总 Token 三张卡片再次相加。
Token 反映模型用量,可以作为容量评估和成本估算的基础数据。页面没有结合模型单价计算货币金额,因此不能直接作为最终费用账单。
五、分析 Token 增长
总 Token 增加可能来自执行数量增加,也可能来自单次执行消耗增加。建议按以下顺序分析:
- 查看 Trace 数量是否同步增长;
- 区分输入 Token 和输出 Token 的变化;
- 估算单条 Trace 的平均 Token;
- 进入链路追踪检查具体模型调用。
辅助计算:
text
平均每条 Trace Token = 总 Token ÷ Trace 数量如果 Trace 数量基本不变,但平均每条 Trace Token 明显增加,应检查提示词、上下文、知识内容、输出长度和模型调用次数。
在链路追踪中分析时,上层 Span 可能包含下层模型调用的汇总 Token,不要重复累计父子 Span。
六、排查错误增加
发现错误数量升高时:
- 确认当前时间范围;
- 将状态切换为“异常”;
- 选择目标 Span 类型;
- 已知具体应用时填写 App ID;
- 点击 刷新;
- 判断异常集中在哪类执行;
- 进入链路追踪筛选异常 Trace;
- 查看异常 Span 的错误、输入和元数据;
- 返回对应模块修复。
| 异常类型 | 优先检查 |
|---|---|
| 模型调用异常 | 模型状态、模型配置和调用参数 |
| 知识检索异常 | Embedding/Rerank 模型和知识库配置 |
| 工具调用异常 | 工具参数、凭证和上游变量 |
| 接口调用异常 | 地址、鉴权、参数及后端服务 |
| 工作流异常 | 节点配置、变量引用、分支和异常处理 |
| Agent 异常 | 提示词、工具描述、最大步数和调用循环 |
七、排查响应变慢
平均耗时升高时,先检查:
- 当前 Trace 数量是否明显增加;
- 统计范围是否混入不同类型的执行;
- 耗时增加是否集中在异常 Trace;
- 最近是否增加知识检索、工具、接口或循环;
- 输入内容和模型输出是否明显变长。
随后进入链路追踪,从耗时较高的 Trace 的 Root Span 开始逐层查看,定位耗时集中在哪个具体 Span。
父 Span 的耗时通常包含子 Span,因此不能把 Span 树中的所有耗时相加。
八、发布前后对比
修改模型、提示词、知识库、工具或工作流并重新发布后,可以比较发布前后的统计结果。
对比时应保持:
- 时间范围长度一致;
- Span 类型一致;
- 状态条件一致;
- App ID 一致;
- 业务使用场景尽量接近。
建议比较:
| 指标 | 关注点 |
|---|---|
| Trace 数量 | 两个周期的执行规模是否接近 |
| 错误数量或错误率 | 新版本是否增加异常 |
| 平均耗时 | 新版本整体是否变慢 |
| 输入 Token | 提示词、上下文或知识内容是否变长 |
| 输出 Token | 生成内容是否变长 |
| 平均每条 Trace Token | 单次执行用量是否增加 |
| 平均每条 Trace 的 Span 数 | 单次执行步骤是否增加 |
如果两个周期的使用规模差异较大,应优先比较错误率、平均耗时和单条 Trace Token,而不是直接比较错误数量或总 Token。